
Actualidad ROLscience · Genómica e inteligencia artificial
AlphaGenome 2
Una misma variante del ADN puede tener efectos distintos según la célula. La nueva IA de DeepMind intenta predecir esas diferencias.

Google DeepMind presentó el 11 de noviembre de 2026 AlphaGenome 2, un modelo de inteligencia artificial que predice cómo las variantes del ADN pueden cambiar la actividad molecular en distintos tipos y estados celulares. Su novedad es incorporar ese contexto para estudiar efectos que pueden quedar diluidos al analizar un tejido completo.[1]
La noticia en un minuto
- Qué analiza: una secuencia de ADN y una condición biológica concreta.
- Qué estima: expresión génica y otras señales de regulación.
- Qué cambia: permite estudiar efectos específicos de tipos y estados celulares.
- Qué muestra el equipo: mejoras en pruebas de referencia, con umbrales definidos.
- Para qué sirve: priorizar variantes, genes y experimentos en investigación.
La novedad · Añadir el contexto celular
Qué es AlphaGenome 2 y qué aporta
AlphaGenome 2 combina información de la secuencia con una condición que representa el tejido, el tipo de célula o su estado. Así puede preguntar qué efecto tendría una variante en un contexto específico, en lugar de limitarse a una salida promedio para un tejido.[3]
El entrenamiento combina datos de genómica funcional humana y de ratón. El componente que representa el estado celular se entrenó con perfiles de expresión de más de cien millones de células humanas: registros de qué genes estaban activos en ellas.[2] [11]
La pregunta biológica · Qué genes se utilizan
Por qué una variante puede actuar de forma distinta en cada célula
Muchas células nucleadas del organismo comparten prácticamente la misma secuencia de ADN, pero utilizan conjuntos distintos de genes. Una célula muscular y una célula inmunitaria necesitan producir moléculas diferentes para desempeñar sus funciones.
La expresión génica es el proceso por el que la información de un gen da lugar a productos funcionales, como ARN o proteínas. La regulación génica controla cuándo, dónde y en qué cantidad se producen. También cambia cuando una célula madura o responde a su entorno.[5] [6]

Parte de esa regulación depende de regiones del ADN no codificante. Entre ellas están los potenciadores, o enhancers, que pueden influir en un gen situado a bastante distancia. Una variante en una de esas regiones puede alterar la regulación sin cambiar directamente la secuencia de una proteína.[7]
Del ADN a la predicción · Comparar dos versiones
Cómo predice el efecto de una variante del ADN
El análisis compara una secuencia de referencia con otra que contiene la variante. Para interpretar la diferencia, ambas se evalúan en la misma condición biológica. La documentación oficial muestra ese procedimiento con predicciones de actividad génica.[4]
- 1. Elegir el contexto. Se especifica un tejido, un tipo celular o una población de células.
- 2. Comparar las secuencias. Se evalúan la versión de referencia y la versión con la variante.
- 3. Estimar el cambio. Se comparan las señales predichas y los genes que podrían verse afectados.
Una ventana de aproximadamente un millón de bases permite incluir regiones que rodean al cambio estudiado. Esto resulta útil al investigar elementos reguladores alejados del gen sobre el que actúan.[4] [7]
Lecturas moleculares · Más allá de un gen encendido
Qué señales de regulación puede estimar
El modelo produce distintas clases de predicciones relacionadas con la función del ADN. DeepMind destaca la incorporación de la metilación del ADN, además de lecturas presentes en el modelo anterior.[1]
| Señal | Qué permite estudiar |
|---|---|
| Expresión génica | Cambios previstos en la actividad de un gen. |
| Accesibilidad de la cromatina | Regiones del ADN disponibles para la maquinaria reguladora. |
| Marcas de histonas y metilación | Características químicas relacionadas con el estado regulador. |

La documentación distingue las modalidades respaldadas por datos experimentales de las predicciones imputadas para una condición. Estas últimas estiman una señal que no se midió directamente en ese contexto; su respaldo debe comprobarse antes de interpretarlas.[3]
Las pruebas · Leer bien los porcentajes
Qué significa que identifique «casi el doble» de variantes
La comparación anunciada procede de las evaluaciones del propio equipo. En TenK10K, una referencia de 28 tipos celulares inmunitarios, el estudio compara AlphaGenome 2 con el primer modelo ajustado a datos de células individuales, denominado AG1-sc.[1] [2]
| Evaluación | AG1-sc | AlphaGenome 2 |
|---|---|---|
| Variantes de referencia recuperadas, al 90 % de precisión | 16 % | 30 % |
| Recuperación al exigir un 90 % de acierto en la dirección del efecto | 23 % | 43 % |
La referencia utiliza variantes asociadas a diferencias de expresión génica, analizadas mediante mapeo fino. Son pruebas de priorización molecular, con sus propios conjuntos de evaluación y criterios.[2]
Un ejemplo concreto · Inflamación y ETS2
El caso del gen ETS2 y los macrófagos
Un estudio publicado en Nature en 2024 investigó una región no codificante asociada al riesgo de enfermedades inflamatorias. Los experimentos vincularon un elemento regulador de esa región con ETS2, un gen relevante para la respuesta inflamatoria de macrófagos humanos.[9]
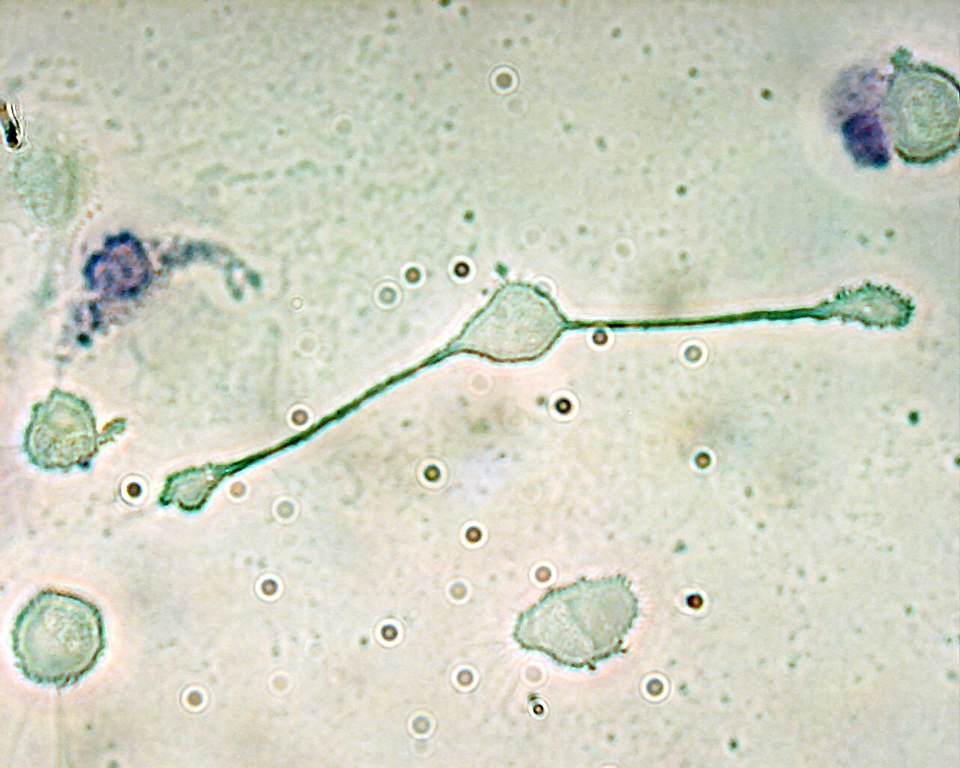
El ejemplo oficial de AlphaGenome 2 analiza siete variantes candidatas en distintos tipos celulares inmunitarios intestinales. El modelo destaca rs2836882, la relaciona con ETS2 y predice un efecto específico en macrófagos y monocitos, en concordancia con los resultados experimentales previos.[10]
Es una comparación retrospectiva: se comprueba si la predicción recupera un mecanismo que ya se había estudiado en el laboratorio. Su interés está en conectar una variante, un gen y las células en las que actúa. Esa conexión puede ayudar a ordenar las hipótesis que después se investigan experimentalmente.[9] [10]
Datos de células individuales · Ampliar el contexto
Cómo se adapta a nuevos estados celulares
Otra capacidad consiste en utilizar datos de expresión de células individuales, obtenidos mediante scRNA-seq, para representar una población celular nueva. Esa representación sirve como condición para las predicciones, sin ajustar de nuevo el modelo para cada conjunto de datos.[8]

Esto permite plantear comparaciones entre poblaciones o estados que un investigador acaba de medir. La documentación también señala que los efectos del lote experimental requieren atención: la calidad y la preparación de los datos siguen influyendo en el análisis.[8]
Alcance del resultado · Qué queda por resolver
Los límites de AlphaGenome 2
Los autores reconocen que, al exigir alta precisión, el modelo recupera todavía una minoría de las variantes de referencia. También puede subestimar ciertos efectos y distinguir con dificultad algunos estados celulares muy parecidos.[2]
El estudio se presenta como prepublicación. Las comparaciones descritas son resultados del equipo desarrollador y su alcance depende de las tareas y datos utilizados. La utilidad práctica consiste en priorizar preguntas y orientar experimentos.
Documentación · Seguir la investigación
Dónde consultar el modelo y sus recursos oficiales
DeepMind ofrece acceso para investigación no comercial mediante la API de AlphaGenome. Los tutoriales explican cómo elegir una condición, comparar variantes y trabajar con perfiles celulares propios. El artículo científico detalla las evaluaciones y sus limitaciones.[1] [11]
Preguntas frecuentes sobre AlphaGenome 2
¿Cuándo se presentó AlphaGenome 2?
Google DeepMind lo anunció el 11 de noviembre de 2026. Esta entrada recoge la información revisada el 18 de noviembre.
¿Qué aporta conocer el tipo de célula?
Permite estudiar cómo una misma variante puede alterar la actividad molecular en una célula concreta y tener un efecto diferente en otra.
¿También estudia ADN que no codifica proteínas?
Sí. El ADN no codificante contiene elementos reguladores que pueden influir en cuándo, dónde y cuánto se expresa un gen.
¿Necesita datos experimentales?
El modelo aprende de datos experimentales. Para una condición nueva puede utilizar perfiles de expresión medidos en células individuales; después genera predicciones que se contrastan con otras evidencias.
Fuentes oficiales y estudio original
- Google DeepMind: anuncio de AlphaGenome 2, 11 de noviembre de 2026.
- Gayoso y colaboradores: AlphaGenome 2 predicts regulatory activity and variant effects across cell states; prepublicación, PDF del equipo.
- Documentación oficial: elección de tejido, tipo celular y estado como condición.
- Documentación oficial: comparación de una secuencia de referencia y una variante.
- NHGRI, NIH: expresión génica.
- NHGRI, NIH: regulación génica.
- MedlinePlus Genetics, NIH: funciones del ADN no codificante y elementos reguladores.
- Documentación oficial: utilizar datos propios de células individuales.
- Stankey y colaboradores, Nature, 2024: estudio experimental de ETS2 y macrófagos; texto completo en PubMed Central.
- Documentación oficial: análisis del locus ETS2 y comparación con los experimentos de 2024.
- Google DeepMind: presentación de AlphaGenome, AlphaGenome 2 y sus recursos.
Fecha de la información: anuncio del 11 de noviembre de 2026, revisado el 18. El manuscrito de AlphaGenome 2 se identifica como prepublicación. Los porcentajes se atribuyen a sus autores y se acompañan de la tarea y el umbral correspondientes.
Imágenes: cinco recursos de Wikimedia Commons, con autoría y licencia en cada pie. Son material ilustrativo de archivo: un modelo del ADN, dos esquemas, un macrófago de ratón y un secuenciador. La tabla resume datos del estudio; las imágenes no se presentan como resultados nuevos de AlphaGenome 2.
Sigue descubriendo con ROLscience
Comprender un avance científico también implica aprender a leer sus pruebas. Descubre más noticias de investigación, explora la biología y encuentra recursos para seguir aprendiendo.
Comentarios
Publicar un comentario